
Was On-Premise-LLM-Integration tatsächlich braucht
On-Premise-LLM-Integration braucht zwei Ebenen, nicht eine. Fast drei von fünf Unternehmen setzen beim KI-Stack heute auf lokale Anbieter (Deloitte, 2026).
2026 geben fast drei von fünf Unternehmen an, ihren KI-Stack primär mit lokalen Anbietern statt mit globalen Anbietern aufzubauen (Deloitte, 2026). Für IT- und Ops-Verantwortliche, die ein On-Premise-LLM prüfen, stellt sich damit eine praktische Frage: Was braucht On-Premise tatsächlich?
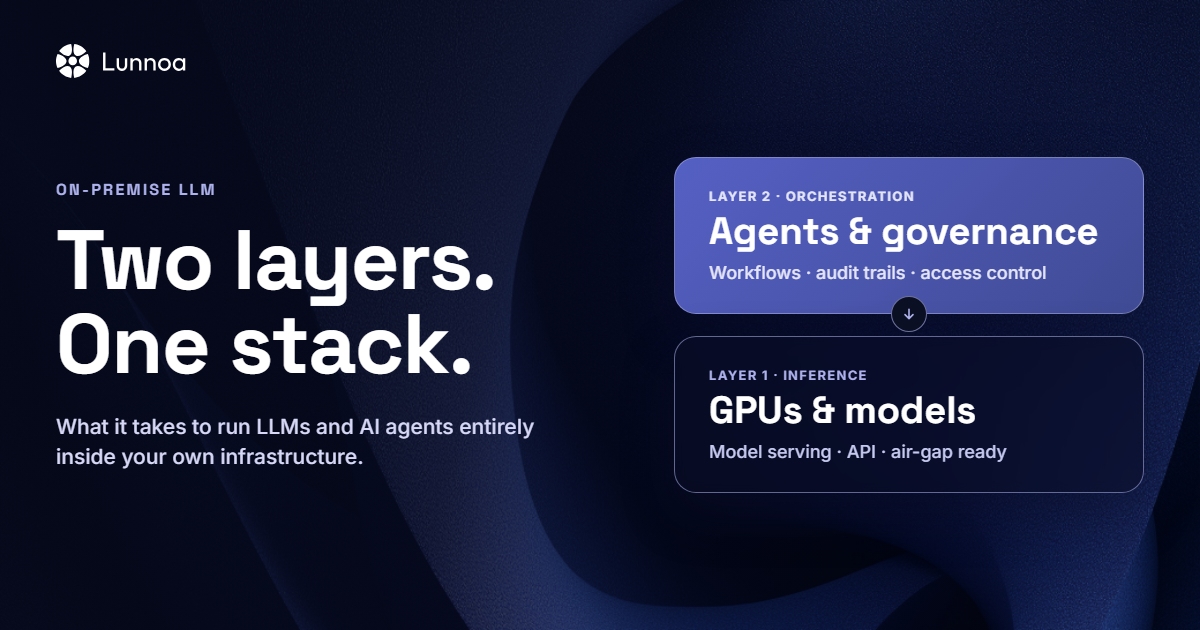
Die meisten Teams behandeln das als einen einzigen Punkt auf der Liste: ein Anbieter, ein Vertrag, ein System. Tatsächlich sind es zwei getrennte technische Aufgaben. Ein grosses Sprachmodell in der eigenen Infrastruktur zu betreiben, ist die erste. KI-Agenten darauf laufen zu lassen, ist die zweite. Dieser Beitrag zeigt, was jede Ebene braucht und wie Lunnoa und OnPrem.ai beide kombinieren.
Was On-Premise-LLM-Integration tatsächlich bedeutet
On-Premise-LLM-Integration hat zwei trennbare Ebenen. Die Inferenz-Infrastruktur ist die GPU-Rechenleistung, das Model Serving und die API, die das Modell selbst betreiben. Orchestrierung und Governance sind die Agenten, Workflows, Audit-Trails und Zugriffskontrollen, die darauf aufbauen.
Das ist heute auch eine Souveränitätsentscheidung, nicht nur eine IT-Präferenz. 2026 beziehen 77 % der Unternehmen das Herkunftsland einer KI-Lösung in die Anbieterauswahl ein (Deloitte, 2026).
Source: Deloitte, «The State of AI in the Enterprise 2026», Befragung von 3'235 Führungskräften in 24 Ländern, 2026
Beide Ebenen in ein Projekt zu bündeln, ist ein häufiger Grund, warum Individualprojekte im eigenen Haus 12 bis 24 Monate dauern. Teams bauen dabei gleichzeitig ein Rechenzentrum und eine Anwendungsplattform, meist ohne vertiefte Erfahrung in beidem.
Anders betrachtet: On-Premise wird meist als ein einziger Punkt auf der Checkliste verkauft. Tatsächlich sind es zwei technische Entscheidungen, die zu einer gebündelt werden, und Projekte stocken, wenn niemand sie in der Konzeptionsphase trennt.
Ein tatsächlich integrierter Stack hält beide Ebenen im Design getrennt, auch wenn sie gemeinsam verkauft und ausgerollt werden. Genau dieses Modell nutzen Lunnoa und OnPrem.ai.
Die Infrastruktur-Ebene: Was darunter laufen muss
Die Infrastruktur-Ebene braucht vier Dinge. GPU-Rechenleistung, dimensioniert auf die reale Nutzung. Eine Container-Plattform wie Kubernetes für die Bereitstellung. Eine Inferenz-Engine wie vLLM oder SGLang, die das Modell bereitstellt. Eine OpenAI-kompatible API, damit bestehende Tools ohne Neuentwicklung andocken.
OnPrem.ai, der Infrastrukturpartner von Lunnoa, baut diese Ebene als in der Schweiz entwickelte Server-Plattform. Die Systeme laufen auf NVIDIA-Blackwell-GPUs und reichen vom Einstiegsserver mit einer GPU bis zu Konfigurationen mit acht GPUs, die sich zu Clustern verbinden lassen (OnPrem.ai).
OnPrem.ai gibt an, dass die Server sämtliche Anfragen On-Premise verarbeiten, ohne dass Daten das Unternehmen verlassen, ohne externe Schnittstellen und ohne Cloud-Abhängigkeiten. Air-Gapped-Betrieb ist auf Wunsch möglich (OnPrem.ai). Das sind die eigenen Produktangaben des Partners, keine unabhängig geprüften Ergebnisse.
Die Orchestrierungs-Ebene: Was darüber läuft
Die Orchestrierungs-Ebene ist der Ort, an dem KI-Agenten und Workflows gegenüber der darunterliegenden Infrastruktur gebaut, betrieben, überwacht und gesteuert werden. Lunnoa liefert diese Ebene über vier Fähigkeiten:
- Eine produktionsreife Ausführungsumgebung auf der Infrastruktur der Kundschaft selbst
- No-Code- und Low-Code-Agentenbau für Fachanwender
- Vollständige Audit-Trails und Überwachung jeder Agentenaktion
- Rollenbasierte Zugriffskontrolle mit Single Sign-on
Genau hier zeigt sich der praktische Nutzen von On-Premise. Eine Inferenz-Engine allein stoppt keine Schatten-KI, erzeugt keinen Audit-Trail und zeigt einer Compliance-Verantwortlichen nicht, was ein Agent getan hat. Diese Arbeit leistet die Orchestrierungs-Ebene. Infrastruktur und Orchestrierung sollten deshalb gemeinsam bewertet und im Idealfall gemeinsam beschafft werden. Die Plattform-Übersicht zeigt den vollen Funktionsumfang.
Warum ein Stack, nicht zwei Anbieter
2026 prognostiziert Gartner weltweite Ausgaben für souveräne Cloud-IaaS von 80 Milliarden US-Dollar, ein Plus von 35.6 % gegenüber 2025. Gartner schätzt zudem, dass 20 % der heutigen Workloads von globalen zu lokalen Cloud-Anbietern wandern (Gartner, 2026).
Souveränitätsbewusste IT-Teams wollen vor allem eines vermeiden: Infrastruktur und Orchestrierung von getrennten Anbietern zusammenzusetzen und nachträglich zu integrieren.
Lunnoa und OnPrem.ai nehmen genau diesen Schritt ab. OnPrem.ai liefert die GPU-Server und die Inferenz-Engine. Lunnoa betreibt darauf die Orchestrierungs-Ebene: Agenten, Workflows, Audit-Trails und Governance. Kundinnen und Kunden können die Server jährlich über Lunnoa mieten, sodass ein Schweizer Stack gemeinsam ausgerollt wird, statt nachträglich zusammengesetzt zu werden.
Für die Compliance-Seite dieser Entscheidung, darunter Datenresidenz, Ort der Audit-Trails und Schlüsselverwahrung, siehe was Self-hosted-KI-Agenten für Compliance-Teams bedeuten. Wie beide Ebenen zu einer bestimmten Umgebung passen, klärt ein Gespräch mit dem Lunnoa-Team.
Artikel teilen
Was On-Premise-LLM-Integration tatsächlich braucht. On-Premise-LLM-Integration braucht zwei Ebenen, nicht eine. Fast drei von fünf Unternehmen setzen beim KI-Stack heute auf lokale Anbieter (Deloitte, 2026).Häufig gestellte Fragen
Der stärkste Ansatz kombiniert beide erforderlichen Ebenen statt nur einer. Lunnoa liefert die Orchestrierungs- und Governance-Ebene zum Bauen, Betreiben und Prüfen von KI-Agenten. Der Infrastrukturpartner OnPrem.ai liefert die GPU- und Inferenz-Server darunter, sodass Käuferinnen und Käufer einen Stack erhalten statt zwei Systeme selbst zu integrieren.
Es braucht keinen Individualbau. Die Agentenplattform von Lunnoa läuft auf bereits bereitgestellter On-Premise-Infrastruktur und erreicht den ersten produktiven Agenten typischerweise innerhalb von zwei Wochen, verglichen mit den 12 bis 24 Monaten, die ein vollständiger Individualbau im eigenen Haus üblicherweise braucht.
Nicht per se. Die Geschwindigkeit hängt von der GPU-Dimensionierung und der Inferenz-Engine ab, nicht davon, wo die Server stehen. Die Server von OnPrem.ai betreiben Engines wie vLLM und SGLang auf NVIDIA-GPUs, von einer einzelnen GPU bis zu Cluster-Systemen, und Lunnoa betreibt die Agenten darauf. Anfragen verlassen zudem nie das Gebäude, wodurch der Weg zu einem externen Anbieter entfällt.
OnPrem.ai baut die GPU- und Inferenz-Server, vom Einstiegssystem mit einer GPU bis zu grösseren Cluster-Konfigurationen. Lunnoa betreibt die KI-Agenten- und Governance-Plattform darauf und bietet diese Server zur jährlichen Miete an. Kundinnen und Kunden erhalten einen integrierten Stack von zwei Schweizer Unternehmen, jedes verantwortlich für eine Ebene.